

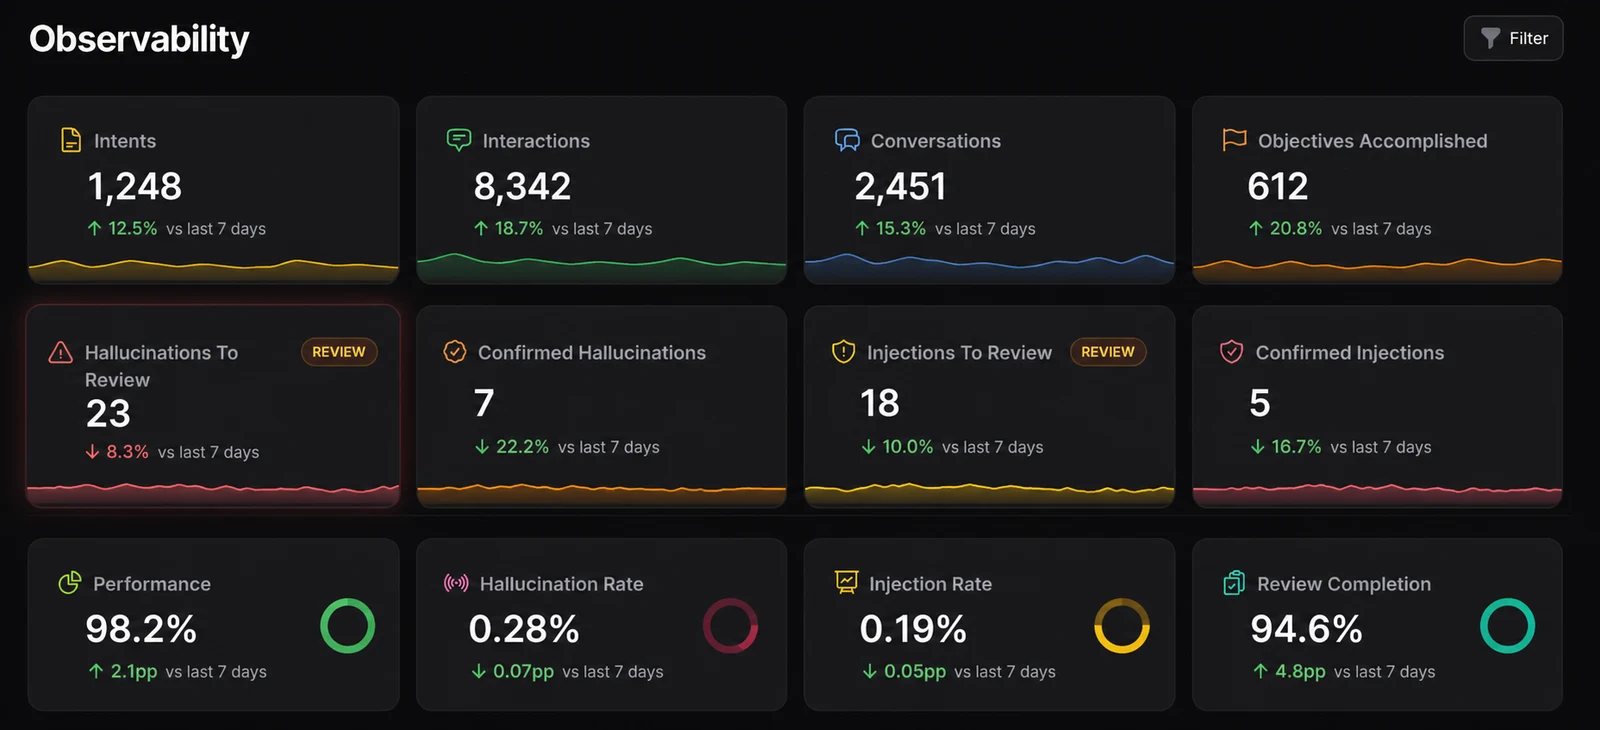
Les agents font de l’observabilité une exigence métier
Les équipes logicielles comprennent déjà pourquoi l’observabilité est importante. Les journaux, les métriques, les traces, les alertes et les processus de gestion des incidents les aident à déterminer si un système fonctionne correctement et pourquoi un changement s’est produit. Les agents IA ont le même besoin, mais ajoutent une difficulté : le système n’est plus constitué uniquement de logiciels déterministes.
Un agent peut recevoir deux fois la même demande et produire des résultats différents. Il peut récupérer un contexte différent, appeler un autre outil, suivre un autre plan ou s’arrêter plus tôt que prévu. Une réponse techniquement réussie peut tout de même être incorrecte, incomplète, trop coûteuse, trop lente ou inadaptée au processus métier qu’elle est censée prendre en charge.
C’est pourquoi l’observabilité des agents ne peut pas se limiter à la disponibilité. Une réponse 200 d’un endpoint LLM ne signifie pas que l’agent a effectué le travail approprié. Les équipes de production doivent savoir ce que l’agent a vu, ce qu’il a utilisé, ce qu’il a décidé, ce qu’il a modifié et si le résultat a créé de la valeur.
Les défaillances de l’IA surviennent souvent silencieusement
Les applications traditionnelles échouent généralement de manière facile à détecter : un service est indisponible, une requête expire, une tâche échoue ou un tableau de bord ne se charge plus. Les agents IA peuvent échouer plus discrètement. Ils peuvent répondre avec assurance tout en s’appuyant sur des connaissances obsolètes. Ils peuvent ignorer un appel d’outil important, résumer incorrectement un document ou produire un résultat plausible en apparence, mais qui ne répond pas à l’exigence opérationnelle.
Les défaillances silencieuses sont particulièrement dangereuses lorsque les agents sont connectés à des processus réels. Dans un processus de support, l’agent peut orienter le dossier vers la mauvaise équipe. Dans un processus de documentation clinique, il peut manquer un élément qui affecte le remboursement. Dans un processus réglementaire, il peut ne pas conserver la traçabilité nécessaire à la revue.
Le risque opérationnel ne tient pas seulement au fait que le modèle puisse se tromper. Il tient aussi à l’incapacité de l’organisation à voir où l’erreur s’est introduite dans le système.
La réponse finale n’est que la dernière étape
De nombreuses équipes commencent par surveiller la réponse finale : était-elle utile, factuelle, pertinente, sûre et conforme à la marque ? Ces vérifications sont importantes. Mais elles ne suffisent pas pour les agents en production, car la réponse finale n’est que l’aboutissement visible d’un processus plus long.
L’observabilité des agents doit suivre le processus, de la source au résultat. Cela signifie suivre la demande de l’utilisateur, l’intention détectée, la version du prompt, les connaissances récupérées, le modèle utilisé, les outils appelés, les autorisations appliquées, la latence et le coût de chaque étape, le résultat final et l’issue en aval.
Sans cette vue d’ensemble, les équipes peuvent constater qu’une réponse est mauvaise sans savoir pourquoi. Le prompt était-il insuffisant ? Les données sources étaient-elles incomplètes ? La récupération a-t-elle renvoyé le mauvais document ? Un outil a-t-il échoué silencieusement ? Le modèle était-il trop limité pour la tâche ? L’agent a-t-il choisi la mauvaise branche du processus ? L’observabilité transforme ces questions en éléments factuels.
Ce que les équipes doivent observer
Les signaux exacts dépendent du cas d’usage, mais les agents en production nécessitent généralement une visibilité sur plusieurs niveaux.
- Entrée et intention : ce que l’utilisateur ou le système a demandé, la manière dont la demande a été classifiée et le processus déclenché.
- Contexte et récupération : les documents, dossiers, sites web, bases de données ou sources de connaissances internes utilisés.
- Exécution du modèle et du prompt : les versions des prompts, les choix de modèles, les paramètres, la latence, le coût, les nouvelles tentatives et les erreurs.
- Activité des outils et des systèmes : les appels d’API, les requêtes de base de données, les actions dans le navigateur, les autorisations, les validations et les transferts.
- Qualité des résultats : la pertinence, l’exactitude factuelle, l’exhaustivité, le ton, la conformité aux politiques et l’utilité pour le processus.
- Résultat métier : la capacité de l’agent à résoudre la demande, à réduire le travail manuel, à améliorer la conversion, à gagner du temps ou à créer une valeur opérationnelle mesurable.
Les évaluations et le traçage sont le socle
Deux capacités sont particulièrement importantes : les évaluations et le traçage.
Les évaluations aident les équipes à mesurer la qualité des résultats à grande échelle. Certains contrôles sont déterministes, par exemple vérifier qu’un champ obligatoire est présent ou qu’une réponse ne contient pas d’affirmation interdite. D’autres utilisent une évaluation fondée sur un modèle pour mesurer des dimensions telles que l’utilité, la pertinence, l’exhaustivité ou le caractère fondé de la réponse sur un contexte approuvé.
Le traçage explique comment un résultat a été produit. Une trace utile montre les étapes suivies par l’agent, les systèmes auxquels il a accédé, le contexte qu’il a récupéré, ainsi que le coût et la latence de chaque partie de l’exécution. Pour les équipes qui gèrent des processus réels, le traçage n’est pas seulement une fonctionnalité de débogage. C’est le moyen d’analyser les incidents, de répondre aux questions des parties prenantes et d’améliorer le processus au fil du temps.
L’observabilité doit couvrir les données, le code, les systèmes et les modèles
Une erreur fréquente consiste à considérer que l’observabilité commence et s’arrête à la frontière du modèle. En pratique, de nombreux problèmes qui ressemblent à des problèmes de modèle sont causés en amont ou en aval.
Les données sources peuvent être obsolètes. Un document peut avoir été indexé incorrectement. Une modification du prompt peut avoir réduit les performances pour un segment spécifique d’utilisateurs. Un outil peut renvoyer des résultats partiels. Une règle d’autorisation peut être trop permissive ou trop restrictive. Le modèle peut être performant, tandis que le processus environnant reste fragile.
Des opérations IA fiables nécessitent une visibilité sur l’ensemble du système : la couche de données, la couche applicative, la couche des prompts et du code, les outils connectés et la couche du modèle. Les agents sont des systèmes de systèmes. L’observabilité doit refléter cette réalité.
L’objectif n’est pas de créer des tableaux de bord. C’est de garder le contrôle.
La supervision n’est utile que si les équipes peuvent agir sur ce qu’elles apprennent. Un tableau de bord qui montre une hausse du taux d’erreur, une augmentation des coûts ou une baisse du score d’évaluation n’est qu’un point de départ. La véritable valeur vient de la capacité à résoudre l’incident.
Il peut s’agir de modifier un prompt, de remplacer une source de connaissances, de désactiver un outil, de renforcer les autorisations, d’ajouter une étape de revue humaine, de déplacer un processus vers un autre modèle ou de créer une nouvelle évaluation pour un mode de défaillance qui n’était pas visible auparavant.
C’est à ce moment que l’observabilité devient opérationnelle. Elle fournit aux équipes une boucle de rétroaction : observer ce qui s’est passé, comprendre pourquoi, modifier le système et mesurer si le changement a amélioré le processus.
Par où commencer
Les équipes n’ont pas besoin d’instrumenter tous les éléments dès le premier jour. Elles doivent toutefois commencer par les signaux correspondant au niveau de risque du processus. Un assistant pour site web public peut commencer par la qualité des réponses, les questions sans réponse, le coût et la conversion. Un agent dédié aux opérations internes peut nécessiter des traces d’outils, des autorisations, des validations et le suivi de l’exécution des tâches. Un processus réglementé peut avoir besoin dès le départ d’un historique des éléments probants, de la gestion des versions et de pistes de revue.
L’essentiel est de concevoir l’observabilité avant que l’agent ne devienne critique. Les pilotes peuvent fonctionner avec une revue manuelle et un débogage ponctuel. Les processus de production, eux, ne le peuvent pas. Dès que de vrais utilisateurs, de vraies données et de vraies décisions métier sont impliqués, la question n’est plus de savoir si l’agent peut produire une bonne démonstration. Il s’agit de déterminer si l’organisation peut l’exploiter de manière responsable.
Les agents IA deviendront plus utiles à mesure qu’ils accéderont à davantage de contexte et d’outils. Cela les rendra également plus difficiles à comprendre sans une visibilité adaptée. L’observabilité permet aux équipes de conserver une puissance exploitable, mesurable et maîtrisée.