

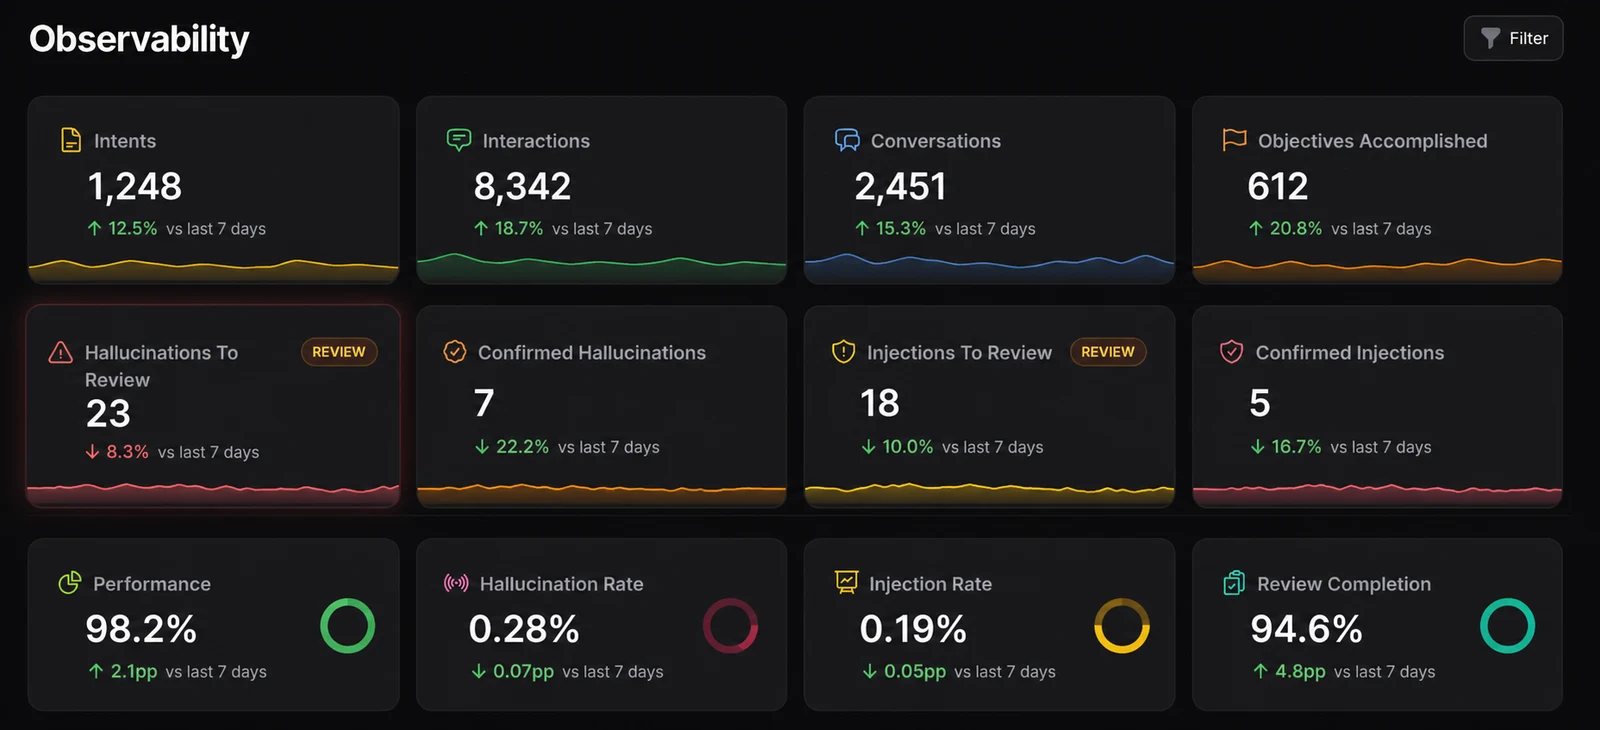
Agenten machen Observability zu einer geschäftlichen Notwendigkeit
Softwareteams verstehen bereits, warum Observability wichtig ist. Logs, Metriken, Traces, Alerts und Incident-Workflows helfen Teams zu erkennen, ob ein System gesund ist und warum sich etwas geändert hat. KI-Agenten haben denselben Bedarf, bringen jedoch ein schwierigeres Problem mit sich: Das System besteht nicht mehr ausschließlich aus deterministischer Software.
Ein Agent kann dieselbe Anfrage zweimal erhalten und unterschiedliche Ergebnisse liefern. Er kann unterschiedlichen Kontext abrufen, ein anderes Tool aufrufen, einem anderen Plan folgen oder früher als erwartet stoppen. Eine technisch erfolgreiche Antwort kann dennoch falsch, unvollständig, zu teuer, zu langsam oder für den Geschäftsprozess, den sie unterstützen soll, ungeeignet sein.
Deshalb darf sich Observability für Agenten nicht auf die Verfügbarkeit reduzieren. Eine 200-Antwort von einem LLM-Endpunkt bedeutet nicht, dass der Agent die richtige Arbeit erledigt hat. Produktionsteams müssen wissen, was der Agent gesehen, verwendet, entschieden und verändert hat – und ob das Ergebnis einen Mehrwert geschaffen hat.
KI-Fehler treten oft unbemerkt auf
Herkömmliche Anwendungen fallen meist auf eine Weise aus, die leicht zu erkennen ist: Ein Service ist nicht verfügbar, eine Anfrage läuft in einen Timeout, ein Job stürzt ab oder ein Dashboard lädt nicht mehr. KI-Agenten können unauffälliger scheitern. Sie können selbstbewusst antworten und dabei veraltetes Wissen verwenden. Sie können einen wichtigen Tool-Aufruf überspringen. Sie können ein Dokument falsch zusammenfassen. Oder sie erzeugen eine plausibel wirkende Ausgabe, die jedoch die operative Anforderung verfehlt.
Unbemerkte Fehler sind besonders gefährlich, wenn Agenten mit realen Workflows verbunden sind. In einem Supportprozess könnte der Agent den Fall an das falsche Team weiterleiten. In einem Prozess zur klinischen Dokumentation könnte er Belege übersehen, die sich auf die Erstattung auswirken. In einem regulatorischen Workflow könnte er die für eine Prüfung erforderliche Nachvollziehbarkeit nicht bewahren.
Das operative Risiko besteht nicht nur darin, dass das Modell falsch liegt. Das Risiko besteht darin, dass die Organisation nicht erkennen kann, an welcher Stelle der Fehler in das System gelangt ist.
Die finale Antwort ist nur der letzte Schritt
Viele Teams beginnen mit der Überwachung der finalen Antwort: War sie hilfreich, sachlich, relevant, sicher und markenkonform? Diese Prüfungen sind wichtig. Für Agenten in der Produktion reichen sie jedoch nicht aus, denn die finale Antwort ist nur das sichtbare Ende eines längeren Workflows.
Observability für Agenten muss den Prozess von der Quelle bis zur Ausgabe verfolgen. Dazu gehört, die Benutzeranfrage, die erkannte Absicht, die Prompt-Version, den abgerufenen Wissenskontext, das verwendete Modell, die aufgerufenen Tools, die angewendeten Berechtigungen, Latenz und Kosten jedes Schritts, die finale Ausgabe und das nachgelagerte Ergebnis zu erfassen.
Ohne diesen vollständigen Pfad können Teams zwar erkennen, dass eine Antwort schlecht war, aber nicht unbedingt warum. War der Prompt zu schwach? Waren die Quelldaten unvollständig? Hat die Suche das falsche Dokument geliefert? Ist ein Tool unbemerkt fehlgeschlagen? War das Modell für die Aufgabe zu klein? Hat der Agent den falschen Prozesszweig gewählt? Observability macht aus diesen Fragen belastbare Erkenntnisse.
Was Teams beobachten sollten
Welche Signale genau erforderlich sind, hängt vom Anwendungsfall ab. Für Agenten in der Produktion benötigen Teams jedoch meist Transparenz über mehrere Ebenen hinweg.
- Eingabe und Absicht: Was der Benutzer oder das System angefordert hat, wie die Anfrage klassifiziert wurde und welcher Workflow ausgelöst wurde.
- Kontext und Suche: Welche Dokumente, Datensätze, Websites, Datenbanken oder internen Wissensquellen verwendet wurden.
- Modellausführung und Prompt-Verarbeitung: Prompt-Versionen, Modellauswahl, Parameter, Latenz, Kosten, Wiederholungen und Fehler.
- Tool- und Systemaktivitäten: API-Aufrufe, Datenbankabfragen, Browser-Aktionen, Berechtigungen, Freigaben und Übergaben.
- Ausgabequalität: Relevanz, Faktentreue, Vollständigkeit, Tonalität, Richtlinienkonformität und Nutzen für den Workflow.
- Geschäftsergebnis: Ob der Agent die Anfrage gelöst, manuellen Aufwand reduziert, die Conversion verbessert, Zeit gespart oder einen messbaren operativen Mehrwert geschaffen hat.
Evaluierungen und Tracing bilden die Grundlage
Zwei Fähigkeiten sind besonders wichtig: Evaluierungen und Tracing.
Evaluierungen helfen Teams, die Qualität von Ausgaben in großem Maßstab zu beurteilen. Einige Prüfungen sind deterministisch, etwa ob ein erforderliches Feld vorhanden ist oder eine Antwort eine unzulässige Behauptung enthält. Andere verwenden modellbasierte Evaluierungen, um Dimensionen wie Hilfsbereitschaft, Relevanz, Vollständigkeit oder die Verankerung der Antwort im freigegebenen Kontext zu bewerten.
Tracing erklärt, wie eine Ausgabe entstanden ist. Ein aussagekräftiger Trace zeigt die Schritte, die der Agent ausgeführt hat, die Systeme, mit denen er interagiert hat, den abgerufenen Kontext sowie Kosten und Latenz jedes Teils des Durchlaufs. Für Teams, die reale Prozesse betreiben, ist Tracing nicht nur eine Funktion zur Fehlerbehebung. Es ermöglicht die Untersuchung von Vorfällen, die Beantwortung von Fragen der Stakeholder und die kontinuierliche Verbesserung des Workflows.
Observability sollte Daten, Code, Systeme und Modelle umfassen
Ein häufiger Fehler besteht darin, Observability als etwas zu betrachten, das an der Modellgrenze beginnt und endet. In der Praxis werden viele Probleme, die wie Modellprobleme aussehen, upstream oder downstream verursacht.
Die Quelldaten können veraltet sein. Ein Dokument kann falsch indexiert worden sein. Eine Prompt-Änderung kann die Performance für ein bestimmtes Nutzersegment verschlechtert haben. Ein Tool liefert möglicherweise nur Teilergebnisse. Eine Berechtigungsregel kann zu weit gefasst oder zu restriktiv sein. Das Modell kann gute Leistung erbringen, während der umgebende Workflow Schwächen aufweist.
Zuverlässiger KI-Betrieb erfordert Transparenz über das gesamte System: die Datenebene, die Anwendungsebene, die Prompt- und Code-Ebene, die verbundenen Tools und die Modellebene. Agenten sind Systeme aus Systemen. Observability muss dieser Realität entsprechen.
Das Ziel sind nicht Dashboards. Das Ziel ist Kontrolle.
Monitoring ist nur dann nützlich, wenn Teams auf die gewonnenen Erkenntnisse reagieren können. Ein Dashboard, das eine steigende Fehlerrate, höhere Kosten oder einen niedrigeren Evaluierungswert zeigt, ist ein Ausgangspunkt. Der eigentliche Wert entsteht, wenn Teams den Vorfall beheben können.
Das kann bedeuten, einen Prompt zu ändern, eine Wissensquelle zu ersetzen, ein Tool zu deaktivieren, Berechtigungen zu verschärfen, einen zusätzlichen Schritt zur menschlichen Prüfung einzuführen, einen Workflow auf ein anderes Modell umzustellen oder eine neue Evaluierung für einen zuvor nicht erkannten Fehlermodus zu erstellen.
Hier wird Observability operativ. Sie schafft eine Feedbackschleife: Beobachten, was passiert ist, verstehen, warum es passiert ist, das System ändern und messen, ob die Änderung den Prozess verbessert hat.
So beginnen Sie
Teams müssen nicht am ersten Tag alles instrumentieren. Sie sollten jedoch mit den Signalen beginnen, die dem Risiko des jeweiligen Prozesses entsprechen. Ein Assistent für eine öffentliche Website kann zunächst Antwortqualität, unbeantwortete Fragen, Kosten und Conversion erfassen. Ein Agent für interne Abläufe benötigt möglicherweise Tool-Traces, Berechtigungen, Freigaben und den Abschluss von Aufgaben. Ein regulierter Workflow braucht möglicherweise von Anfang an eine Beleg-Historie, Versionierung und Prüfpfade.
Der entscheidende Schritt besteht darin, Observability zu planen, bevor der Agent kritisch wird. Piloten können mit manueller Prüfung und spontaner Fehleranalyse auskommen. Produktionsworkflows können das nicht. Sobald echte Benutzer, echte Daten und echte Geschäftsentscheidungen beteiligt sind, lautet die Frage nicht mehr, ob der Agent eine gute Demo liefern kann. Die Frage ist, ob die Organisation ihn verantwortungsvoll betreiben kann.
KI-Agenten werden nützlicher, wenn sie Zugriff auf mehr Kontext und mehr Tools erhalten. Dadurch wird es ohne die richtige Transparenz jedoch auch schwieriger, sie zu verstehen. Observability hilft Teams, diese Leistungsfähigkeit nutzbar, messbar und kontrollierbar zu halten.