

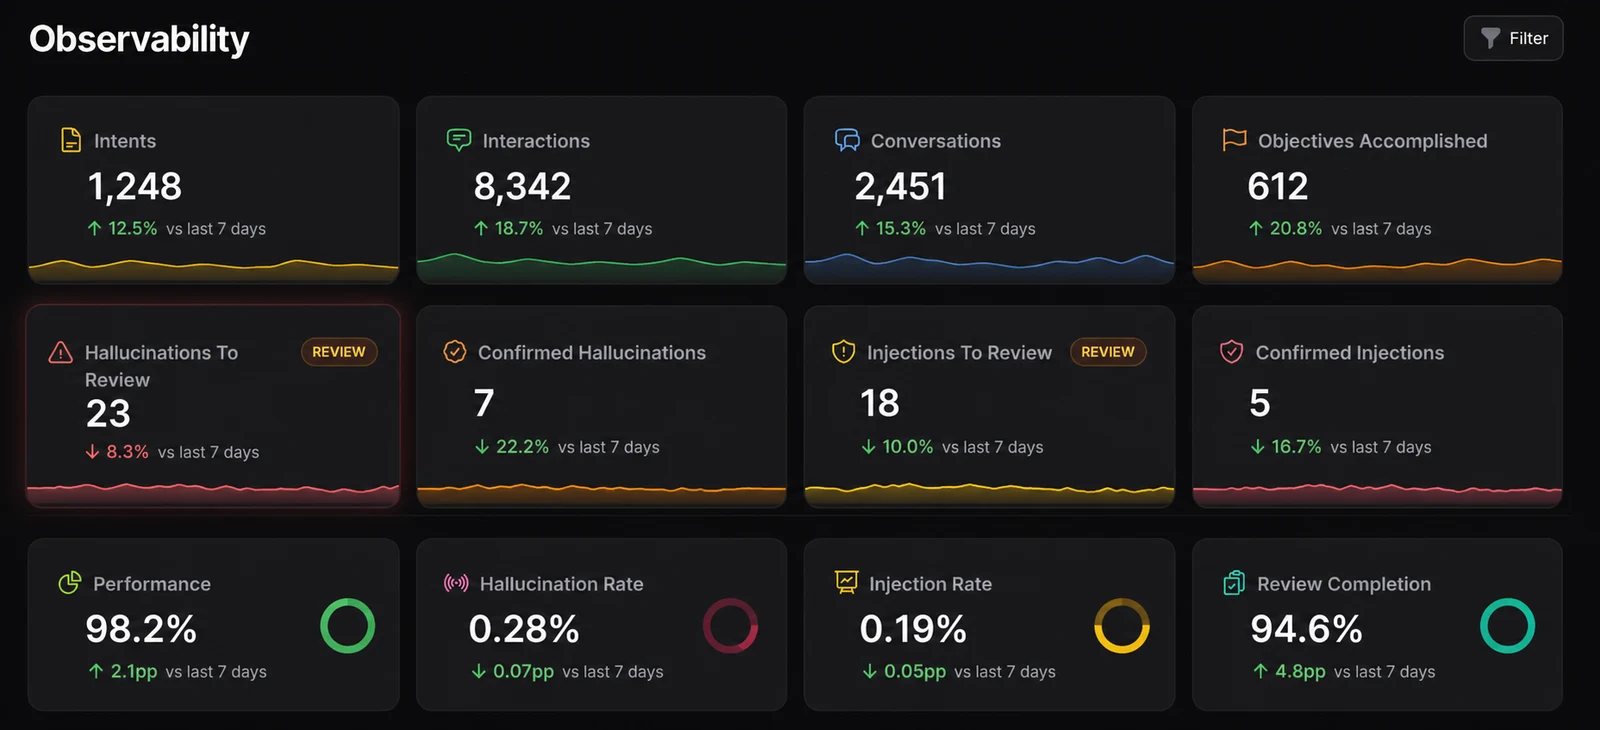
Os agentes tornam a observabilidade um requisito de negócio
As equipes de software já entendem por que a observabilidade é importante. Logs, métricas, rastreamentos, alertas e fluxos de trabalho para incidentes ajudam as equipes a entender se um sistema está saudável e por que algo mudou. Os agentes de IA herdam essa necessidade, mas acrescentam um problema mais difícil: o sistema deixa de ser apenas um software determinístico.
Um agente pode receber a mesma solicitação duas vezes e produzir resultados diferentes. Ele pode recuperar contextos diferentes, chamar outra ferramenta, seguir um plano diferente ou parar antes do esperado. Uma resposta tecnicamente bem-sucedida ainda pode estar errada, incompleta, ser cara demais, lenta demais ou inadequada para o processo de negócio que deveria apoiar.
Por isso, a observabilidade de agentes não pode ser reduzida à disponibilidade. Uma resposta 200 de um endpoint de LLM não significa que o agente executou o trabalho corretamente. As equipes de produção precisam saber o que o agente viu, o que usou, o que decidiu, o que alterou e se o resultado gerou valor.
As falhas de IA geralmente acontecem de forma silenciosa
Aplicações tradicionais costumam falhar de maneiras fáceis de detectar: um serviço fica indisponível, uma solicitação expira, um job falha ou um painel deixa de carregar. Agentes de IA podem falhar de forma mais silenciosa. Eles podem responder com confiança usando conhecimento desatualizado. Podem ignorar uma chamada importante de ferramenta. Podem resumir um documento incorretamente. Podem produzir um resultado que parece plausível, mas não atende ao requisito operacional.
Falhas silenciosas são especialmente perigosas quando os agentes estão conectados a fluxos de trabalho reais. Em um processo de suporte, o agente pode encaminhar o caso para a equipe errada. Em um processo de documentação clínica, pode deixar passar evidências que afetam o reembolso. Em um fluxo regulatório, pode não preservar a rastreabilidade necessária para a revisão.
O risco operacional não é apenas o modelo estar errado. O risco é a organização não conseguir ver em que ponto o erro entrou no sistema.
A resposta final é apenas a última etapa
Muitas equipes começam monitorando a resposta final: ela foi útil, factual, relevante, segura e alinhada à marca? Essas verificações são importantes. Mas não são suficientes para agentes em produção, porque a resposta final é apenas a parte visível de um fluxo de trabalho mais longo.
A observabilidade de agentes precisa acompanhar o processo desde a origem até o resultado. Isso significa rastrear a solicitação do usuário, a intenção identificada, a versão do prompt, o conhecimento recuperado, o modelo utilizado, as ferramentas chamadas, as permissões aplicadas, a latência e o custo de cada etapa, o resultado final e o desfecho posterior.
Sem esse caminho completo, as equipes podem perceber que uma resposta foi ruim, mas ainda assim não saber por quê. O prompt era fraco? Os dados de origem estavam incompletos? A recuperação retornou o documento errado? Uma ferramenta falhou silenciosamente? O modelo era pequeno demais para a tarefa? O agente escolheu o ramo errado do processo? A observabilidade transforma essas perguntas em evidências.
O que as equipes devem observar
Os sinais exatos dependem do caso de uso, mas os agentes em produção geralmente precisam de visibilidade em várias camadas.
- Entrada e intenção: o que o usuário ou sistema solicitou, como a solicitação foi classificada e qual fluxo de trabalho foi acionado.
- Contexto e recuperação: quais documentos, registros, sites, bancos de dados ou fontes internas de conhecimento foram utilizados.
- Execução do modelo e do prompt: versões dos prompts, escolhas de modelos, parâmetros, latência, custo, novas tentativas e erros.
- Atividade de ferramentas e sistemas: chamadas de API, consultas a bancos de dados, ações no navegador, permissões, aprovações e transferências.
- Qualidade do resultado: relevância, factualidade, completude, tom, conformidade com políticas e utilidade para o fluxo de trabalho.
- Resultado de negócio: se o agente resolveu a solicitação, reduziu o trabalho manual, melhorou a conversão, economizou tempo ou gerou valor operacional mensurável.
Avaliações e rastreamento são a base
Duas capacidades são especialmente importantes: avaliações e rastreamento.
As avaliações ajudam as equipes a julgar a qualidade dos resultados em escala. Algumas verificações são determinísticas, como confirmar se um campo obrigatório está presente ou se uma resposta inclui uma afirmação proibida. Outras usam avaliação baseada em modelos para analisar dimensões como utilidade, relevância, completude ou se a resposta está fundamentada em um contexto aprovado.
O rastreamento explica como um resultado foi produzido. Um rastreamento útil mostra as etapas realizadas pelo agente, os sistemas acessados, o contexto recuperado e o custo e a latência de cada parte da execução. Para equipes que operam processos reais, o rastreamento não é apenas um recurso de depuração. É a forma de revisar incidentes, responder às perguntas das partes interessadas e melhorar o fluxo de trabalho ao longo do tempo.
A observabilidade deve incluir dados, código, sistemas e modelos
Um erro comum é tratar a observabilidade como algo que começa e termina na fronteira do modelo. Na prática, muitos problemas que parecem ser problemas do modelo são causados antes ou depois dele.
Os dados de origem podem estar desatualizados. Um documento pode ter sido indexado incorretamente. Uma mudança no prompt pode ter reduzido o desempenho para um segmento específico de usuários. Uma ferramenta pode estar retornando resultados parciais. Uma regra de permissão pode ser ampla ou restritiva demais. O modelo pode estar tendo um bom desempenho, mas o fluxo de trabalho ao redor pode ser fraco.
Operações confiáveis de IA exigem visibilidade sobre todo o sistema: a camada de dados, a camada de aplicação, a camada de prompts e código, as ferramentas conectadas e a camada do modelo. Agentes são sistemas de sistemas. A observabilidade precisa refletir essa realidade.
O objetivo não são os painéis. O objetivo é o controle.
O monitoramento só é útil se as equipes puderem agir com base no que aprendem. Um painel que mostra uma taxa de erros crescente, custos mais altos ou uma pontuação de avaliação menor é um ponto de partida. O verdadeiro valor vem da capacidade de resolver o incidente.
Isso pode significar alterar um prompt, substituir uma fonte de conhecimento, desativar uma ferramenta, restringir permissões, adicionar uma etapa de revisão humana, transferir um fluxo de trabalho para outro modelo ou criar uma nova avaliação para um modo de falha que antes não era visível.
É nesse ponto que a observabilidade se torna operacional. Ela oferece às equipes um ciclo de feedback: observar o que aconteceu, entender por que aconteceu, alterar o sistema e medir se a mudança melhorou o processo.
Como começar
As equipes não precisam instrumentar tudo no primeiro dia. Mas devem começar pelos sinais que correspondem ao risco do processo. Um assistente de site público pode começar com qualidade das respostas, perguntas sem resposta, custo e conversão. Um agente interno de operações pode precisar de rastreamentos de ferramentas, permissões, aprovações e conclusão de tarefas. Um fluxo regulado pode precisar, desde o início, de histórico de evidências, controle de versões e trilhas de revisão.
O passo importante é projetar a observabilidade antes que o agente se torne crítico. Pilotos podem funcionar com revisão manual e depuração improvisada. Fluxos de trabalho em produção, não. Quando usuários reais, dados reais e decisões reais de negócio estão envolvidos, a questão já não é se o agente consegue produzir uma boa demonstração. A questão é se a organização consegue operá-lo com responsabilidade.
Os agentes de IA se tornarão mais úteis à medida que ganharem acesso a mais contexto e mais ferramentas. Isso também os torna mais difíceis de entender sem a visibilidade adequada. A observabilidade é o que permite às equipes manter esse poder utilizável, mensurável e sob controle.