

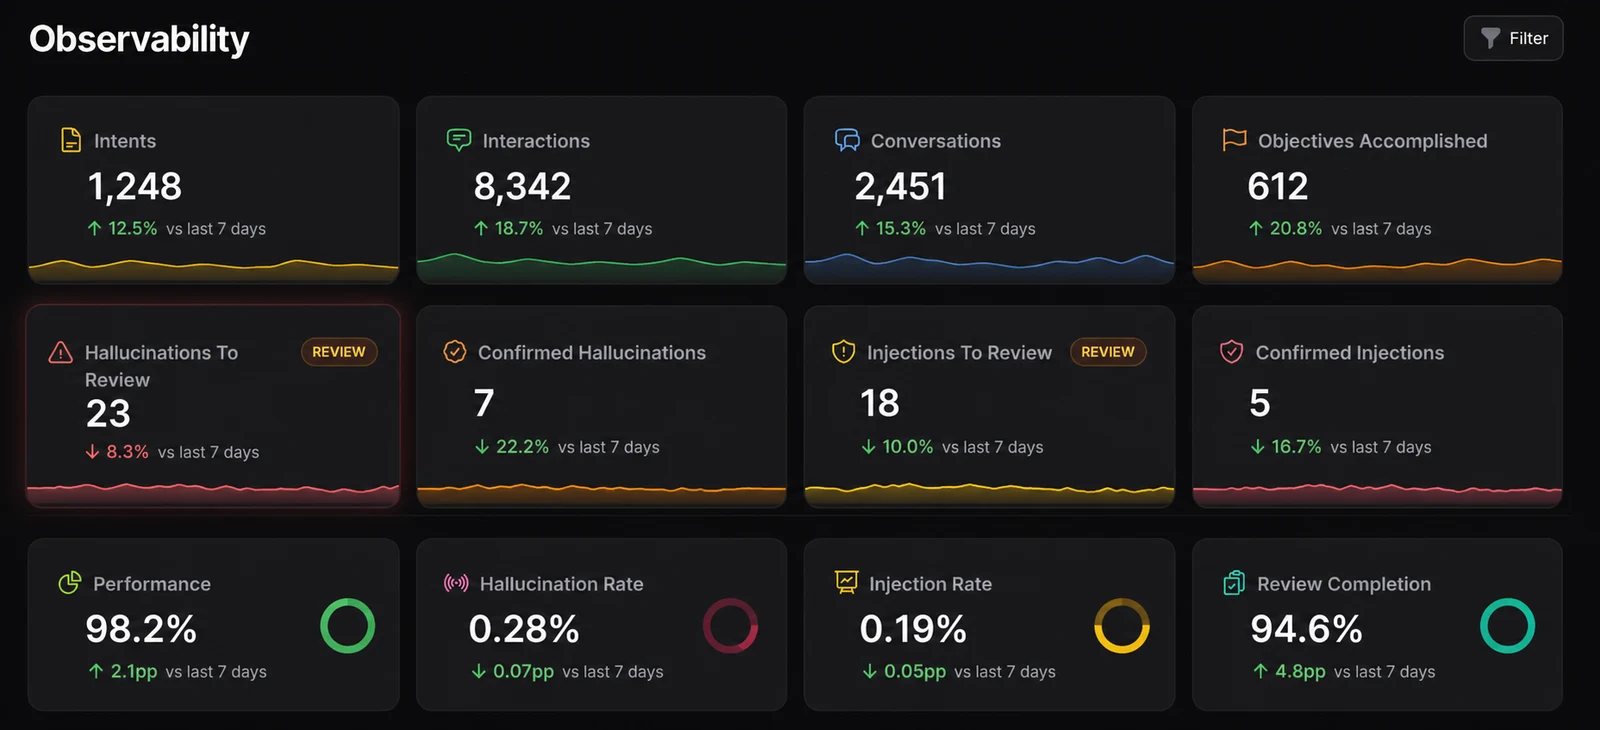
Los agentes convierten la observabilidad en un requisito empresarial
Los equipos de software ya entienden por qué es importante la observabilidad. Los registros, las métricas, las trazas, las alertas y los flujos de trabajo de incidentes ayudan a comprender si un sistema funciona correctamente y por qué ha cambiado algo. Los agentes de IA heredan esa necesidad, pero añaden un problema más complejo: el sistema ya no está compuesto únicamente por software determinista.
Un agente puede recibir dos veces la misma solicitud y producir resultados diferentes. Puede recuperar un contexto distinto, llamar a otra herramienta, seguir un plan diferente o detenerse antes de lo previsto. Una respuesta técnicamente correcta puede seguir siendo errónea, incompleta, demasiado costosa, demasiado lenta o inadecuada para el proceso empresarial al que debe dar soporte.
Por eso, la observabilidad de los agentes no puede reducirse al tiempo de actividad. Una respuesta 200 de un endpoint de LLM no significa que el agente haya realizado el trabajo correcto. Los equipos de producción necesitan saber qué vio el agente, qué utilizó, qué decidió, qué cambió y si el resultado generó valor.
Los fallos de la IA suelen producirse de forma silenciosa
Las aplicaciones tradicionales suelen fallar de formas fáciles de detectar: un servicio deja de estar disponible, una solicitud agota el tiempo de espera, un trabajo falla o un panel deja de cargar. Los agentes de IA pueden fallar de forma más silenciosa. Pueden responder con seguridad mientras utilizan conocimientos obsoletos. Pueden omitir una llamada importante a una herramienta. Pueden resumir incorrectamente un documento. Pueden generar un resultado plausible que no cumple el requisito operativo.
Los fallos silenciosos son especialmente peligrosos cuando los agentes están conectados a flujos de trabajo reales. En un proceso de soporte, el agente podría derivar el caso al equipo equivocado. En un proceso de documentación clínica, podría omitir evidencia que afecte al reembolso. En un flujo de trabajo regulatorio, podría no conservar la trazabilidad necesaria para la revisión.
El riesgo operativo no consiste únicamente en que el modelo se equivoque. El riesgo es que la organización no pueda ver en qué punto entró el error en el sistema.
La respuesta final es solo el último tramo
Muchos equipos comienzan supervisando la respuesta final: ¿fue útil, objetiva, relevante, segura y coherente con la marca? Esas comprobaciones son importantes. Pero no bastan para los agentes en producción, porque la respuesta final solo es el extremo visible de un flujo de trabajo más largo.
La observabilidad de los agentes debe seguir el proceso desde el origen hasta el resultado. Esto implica rastrear la solicitud del usuario, la intención detectada, la versión del prompt, los conocimientos recuperados, el modelo utilizado, las herramientas llamadas, los permisos aplicados, la latencia y el coste de cada paso, el resultado final y el resultado posterior.
Sin ese recorrido completo, los equipos pueden ver que una respuesta fue deficiente, pero seguir sin saber por qué. ¿Era débil el prompt? ¿Estaban incompletos los datos de origen? ¿La recuperación devolvió el documento equivocado? ¿Falló una herramienta de forma silenciosa? ¿Era demasiado pequeño el modelo para la tarea? ¿Eligió el agente la rama incorrecta del proceso? La observabilidad convierte estas preguntas en evidencia.
Qué deben observar los equipos
Las señales exactas dependen del caso de uso, pero los agentes en producción suelen necesitar visibilidad en varias capas.
- Entrada e intención: qué solicitó el usuario o el sistema, cómo se clasificó la solicitud y qué flujo de trabajo se activó.
- Contexto y recuperación: qué documentos, registros, sitios web, bases de datos o fuentes internas de conocimiento se utilizaron.
- Ejecución del modelo y del prompt: versiones de los prompts, elección de modelos, parámetros, latencia, coste, reintentos y errores.
- Actividad de herramientas y sistemas: llamadas a API, consultas a bases de datos, acciones en el navegador, permisos, aprobaciones y derivaciones.
- Calidad del resultado: relevancia, veracidad, integridad, tono, cumplimiento de políticas y utilidad para el flujo de trabajo.
- Resultado empresarial: si el agente resolvió la solicitud, redujo el trabajo manual, mejoró la conversión, ahorró tiempo o generó un valor operativo medible.
Las evaluaciones y las trazas son la base
Hay dos capacidades especialmente importantes: las evaluaciones y las trazas.
Las evaluaciones ayudan a los equipos a juzgar la calidad de los resultados a escala. Algunas comprobaciones son deterministas, como verificar si está presente un campo obligatorio o si una respuesta incluye una afirmación prohibida. Otras utilizan evaluaciones basadas en modelos para valorar dimensiones como la utilidad, la relevancia, la integridad o si la respuesta se fundamenta en un contexto aprobado.
Las trazas explican cómo se produjo un resultado. Una traza útil muestra los pasos que siguió el agente, los sistemas con los que interactuó, el contexto que recuperó y el coste y la latencia de cada parte de la ejecución. Para los equipos que operan procesos reales, las trazas no son solo una función de depuración. Son la forma de revisar incidentes, responder a las preguntas de las partes interesadas y mejorar el flujo de trabajo con el tiempo.
La observabilidad debe incluir datos, código, sistemas y modelos
Un error común es tratar la observabilidad como algo que comienza y termina en los límites del modelo. En la práctica, muchos problemas que parecen ser problemas del modelo tienen su origen antes o después de él.
Los datos de origen pueden estar obsoletos. Un documento puede haberse indexado incorrectamente. Un cambio en un prompt puede haber reducido el rendimiento para un segmento específico de usuarios. Una herramienta puede estar devolviendo resultados parciales. Una regla de permisos puede ser demasiado amplia o demasiado restrictiva. El modelo puede funcionar bien, pero el flujo de trabajo que lo rodea puede ser deficiente.
Las operaciones de IA fiables requieren visibilidad de todo el sistema: la capa de datos, la capa de aplicación, la capa de prompts y código, las herramientas conectadas y la capa del modelo. Los agentes son sistemas de sistemas. La observabilidad debe reflejar esa realidad.
El objetivo no son los paneles. El objetivo es el control.
La supervisión solo es útil si los equipos pueden actuar a partir de lo que aprenden. Un panel que muestra un aumento de la tasa de errores, un coste mayor o una puntuación de evaluación más baja es un punto de partida. El valor real surge cuando es posible resolver el incidente.
Esto puede implicar cambiar un prompt, sustituir una fuente de conocimiento, desactivar una herramienta, reforzar los permisos, añadir un paso de revisión humana, trasladar un flujo de trabajo a otro modelo o crear una evaluación nueva para un modo de fallo que antes no era visible.
Aquí es donde la observabilidad se vuelve operativa. Proporciona a los equipos un ciclo de retroalimentación: observar qué ocurrió, entender por qué ocurrió, modificar el sistema y medir si el cambio mejoró el proceso.
Cómo empezar
Los equipos no necesitan instrumentarlo todo desde el primer día. Pero sí deben comenzar con las señales que correspondan al riesgo del proceso. Un asistente para un sitio web público puede empezar con la calidad de las respuestas, las preguntas sin respuesta, el coste y la conversión. Un agente interno de operaciones puede necesitar trazas de herramientas, permisos, aprobaciones y finalización de tareas. Un flujo de trabajo regulado puede necesitar desde el principio un historial de evidencias, control de versiones y registros de revisión.
Lo importante es diseñar la observabilidad antes de que el agente se vuelva crítico. Los pilotos pueden funcionar con revisión manual y depuración puntual. Los flujos de trabajo de producción no. Cuando intervienen usuarios reales, datos reales y decisiones empresariales reales, la pregunta ya no es si el agente puede ofrecer una buena demostración. La pregunta es si la organización puede operarlo de forma responsable.
Los agentes de IA serán más útiles a medida que obtengan acceso a más contexto y más herramientas. Eso también hará que sean más difíciles de entender sin la visibilidad adecuada. La observabilidad es la forma en que los equipos mantienen ese poder utilizable, medible y bajo control.